

Get security briefings from the Threat Research Team
New campaigns, attacker techniques, and detection guidance — straight to your inbox.

Falco Feedsは、オープンソースに焦点を当てた企業に、新しい脅威が発見されると継続的に更新される専門家が作成したルールにアクセスできるようにすることで、Falcoの力を拡大します。
本文の内容は、2026年10月27日に Lydia Graslie が投稿したブログ (URL) を元に日本語に翻訳・再構成した内容となっております。
機械学習(ML)のエコシステムでは最近、悪意あるモデルファイルに対する一連の防御策が導入されました。PyTorch は、ローダーがデシリアライズできる対象を制限しました。Keras は、埋め込まれたコードの実行を拒否するセーフモードを追加しました。ベンダー各社は、保存状態のモデルファイルを検査し、危険なものを拒否するスキャナーを構築しました。
しかし、それらはいずれも、文書化された 6 件の CVE によるバイパスに耐えられませんでした。「pickle」と呼ばれることの多いこれらのバイパスにより、悪意ある Python データファイルが、セキュリティスキャナーに検知されないまますり抜けてしまいます。そして Sysdig Threat Research Team(TRT)が、記録されている公開済みの pickle バイパスをすべて分解して調べたところ、あるパターンが浮かび上がってきました。
そのパターンを探る前に、まず pickle とは実際に何なのか、そしてなぜ機械学習(ML)が pickle だらけなのかを理解しましょう。そのうえで、どのモデルフォーマットが最も危険なのか、悪意あるモデルのロードを 2 つの検知エンジンに対して実行した際に Sysdig TRT が何を計測したのか、そして脆弱性を抱えるモデルを環境にどうデプロイして保護するのが最善かを分析します。
pickle はプログラムである
Pickle は Python に組み込まれた機能で、メモリ上のものをファイルに保存し、後でまったく同じ状態で読み込めるようにします。多くのチームが、自覚のないまま pickle を使っているかもしれません。torch.save() や joblib はどちらも pickle であり、この見えない誤解がエクスポージャーを高め、誰にも気づかれず、理由もわからないまま問題が起きやすくなっています。
ほとんどのファイルフォーマットはデータです。パースすれば構造が返ってきて、ファイルの中身がプログラムの次の動作に口を挟むことはありません。たとえば、壊れた JPEG はエラーになるだけで、シェルが起動することはありません。
pickle はそのようなフォーマットではありません。pickle.load() はパースではなく実行します。.pkl ファイルは、CPython に組み込まれた小さなスタックベースの仮想マシン向けの命令列であり、ファイルを読み込むことはそれらを実行することを意味します。これは修正されるような実装上の欠陥やパーサーのバグではなく、設計そのものです。
それを信じる最も簡単な方法は、実際に 1 つ読んでみることです。pickle のプロトコル 0 は設計上、人間が読める形式になっており、以下は完全に動作するペイロードです。
cos          GLOBAL  → push os.system onto the stack
system
(            MARK
S'id'        push the string "id"
tR           TUPLE → ("id",)  then  REDUCE → call os.system("id")
.            STOP
上のスニペットには 5 つの命令が含まれており、機能的にはアセンブリそのものなので、アセンブリのように読めます。
GLOBALは呼び出し可能オブジェクトを解決してプッシュします。MARKとTUPLEは引数のタプルを組み立てます。REDUCEはそれらの引数で呼び出し可能オブジェクトを呼び出します。STOPはプログラムを終了します。"id"をもっと野心的なものに差し替えても、構造は何も変わりません。
これがリモートコード実行(RCE)の全貌であり、必要なのはわずか 3 つの操作コード(オペコード)だけです。何かをインポートし、引数のタプルを組み立て、呼び出す。それ以外のすべて、つまり後続のプロトコルバージョン、メモテーブル、フレーミング、アウトオブバンドバッファは、この核心部分を最適化するためのものです。
しかもペイロードはオペコードだけなので、漏洩するオフセットも、フィンガープリントできるビルドもありません。ある Python で動作するものは、そのプロトコルをパースできるあらゆる Python で動作します。
通常、これらのオペコードを手書きすることもありません。Python は、文書化された拡張ポイントを通じて自動的に生成してくれます。
import os, pickle

class Evil:
    def __reduce__(self):
        return (os.system, ("id",))

payload = pickle.dumps(Evil())
__reduce__ は、オブジェクトが自身の再構築方法を pickle に伝えるための仕組みです。このメソッドは呼び出し可能オブジェクトとその引数を指定し、pickle はロード時にそれらを呼び出します。単純にはシリアライズできないオブジェクトが、反対側で自らを再構築できるのはこのためです。攻撃はこれを覆すわけではありません。pickle を仕様どおりに使い、呼び出し可能オブジェクトとして os.system を指名するだけです。
たとえば、次のスクリプトを見てください。
import os, pickle, pickletools

class Evil:
    def __reduce__(self):
        return (os.system, ("echo pwned",))

pickletools.dis(pickle.dumps(Evil()))
pickletools.dis は、バイトストリームを実行せずに逆アセンブルし、その出力はリストのように読めます。GLOBAL、MARK、SHORT_BINUNICODE、TUPLE1、REDUCE、STOP です。逆アセンブルは自由に行って構いません。そのペイロードに対して pickle.loads を実行するのは、失っても構わない環境に限ってください。
この帰結が持つ大きな意味
pickle がプログラムであるなら、全体としては不正なファイルでも、一部は完全に有効に機能し得ます。VM はオペコードに出会った順に実行します。ストリームを事前に検証してから実行するわけではなく、そもそも「事前」というものが存在しません。VM は、終了するか、実行できないものに到達するまで走り続けます。その時点より前のことは、すべてすでに起きています。
データであれば、パースしてから使うので、壊れたファイルからは何も得られません。プログラムは、障害が起きるまで実行されます。
攻撃者はこれに気づいており、これについては第 3 節で改めて取り上げます。
そもそもなぜ機械学習は pickle だらけなのか
pickle は現実の問題を解決しますが、その解決方法には、まさに危険性の源となる能力が必要です。
問題とは、汎用的なオブジェクトのシリアライズです。整数のリストをディスクに書き込むのは簡単です。しかし、任意の Python オブジェクトを書き込むのは簡単ではありません。
オブジェクトは、他のオブジェクトへの参照、まだインポートされていないかもしれないモジュールで定義されたクラスへの参照、そして何かが再構築して初めて意味を持つ状態を保持しています。「これをどう再構築するか」を表す普遍的な宣言的記述は存在しません。一般的な答えは、手順、つまり「これをこの引数で呼び出す」を記録し、ロード時に実行することです。
それがまさに __reduce__ であり、標準ライブラリもまさにその言葉で仕様を定めています。__reduce__ のタプルの最初の 2 つの要素は次のとおりです。
- オブジェクトの初期バージョンを作成するために呼び出される、呼び出し可能オブジェクト。
- その呼び出し可能オブジェクトに渡す引数のタプル。
これを攻撃者として読めば、エクスプロイトはひとりでに書き上がります。しかし言語設計者として読めば、それは唯一可能な汎用的な答えです。
つまり、任意コード実行は pickle のバグではなく、機能です。Python もこの点を隠したことはありません。警告は、モジュールのドキュメントの冒頭に書かれています。
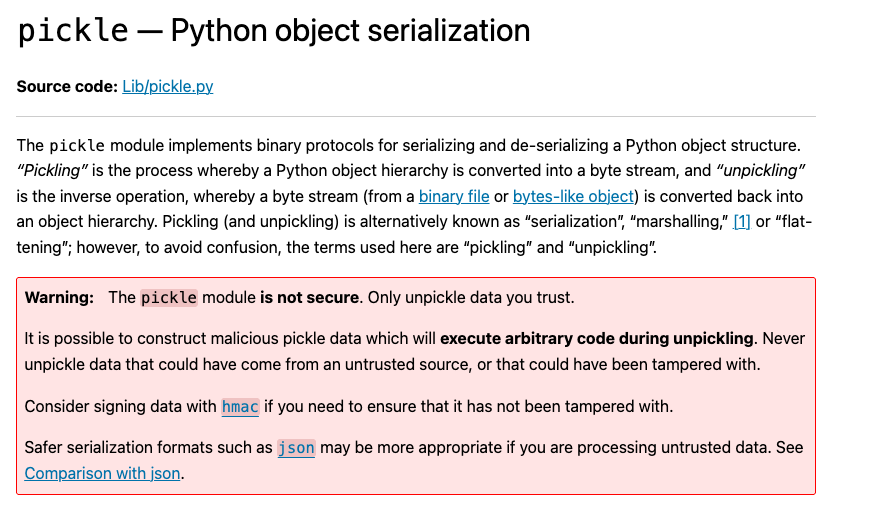
ドキュメントは、緩和策にも言及しています。「Restricting Globals」というセクションでは、多くのアプリケーションにおいてデフォルトの動作は「アンピクラーが任意のコードをインポートして呼び出すことを許してしまうため、受け入れられない」と述べたうえで、想定したものだけを許可するようにアンピクラーをサブクラス化する方法を示しています。
では、機械学習はどうして pickle の上に築かれたのか
torch.save は pickle でシリアライズします。モデルの保存は 1 回の呼び出しで済み、成果物は .pt、.pth、.bin のいずれかになりますが、ファイル一覧を眺めても、それが pickle だとわかる人はいません。scikit-learn の永続化に関するガイダンスは joblib を勧めています。これは、大きな NumPy 配列を持つオブジェクト向けに最適化された pickle のラッパーで、学習済みの推定器はまさにそのようなオブジェクトです。NumPy 自身の .npy も、配列に Python オブジェクトが含まれるまでは単なる数値コンテナです。その時点で pickle が必要になり、これが allow_pickle フラグが存在する理由です。
この連鎖の中で、誰も任意コード実行を選んだわけではありません。彼らが選んだのは「Python オブジェクトを保存する」ことで、これは誰もが欲しがる当然の API であり、pickle はそれを提供する、すぐに使える手段なのです。
その結果、サプライチェーンは pickle が過半数を占めるものになりました。Hugging Face のミラー上の 705,991 件のモデルを対象とした調査では、PyTorch の .pt、.pth、 .bin が 335,893 件のモデル(51.0%)を占め、明示的な pickle の亜種(.pkl、.pickle、.joblib、.dill)がさらに 26,696 件(4.1%)を占めていました。ダウンロードし得るモデルの半数以上が、ロードした瞬間にコードを実行するのです。
なぜ「pickle を直せばいい」という話にならないのか
pickle.load を汎用的かつ安全にすることはできません。汎用性こそが、呼び出しを必要とするものだからです。ただし、次の 2 つの、より限定的なことならできます。
- ローダーを制限する。フォーマットは維持しつつ、安全であることがわかっている呼び出し可能オブジェクトのサブセットだけを許可します。これは標準ライブラリ自身の提案であり、PyTorch の
weights_only=Trueや Keras のsafe_modeは、この考え方をモデルファイルに適用したものです。 - フォーマットを変える。モデルが実際に必要とするもの、たとえば名前付きの数値配列だけを、呼び出しを表現する手段がまったくないコンテナに保存します。それが
safetensorsです。
どちらのアプローチも、原理的には健全です。実際の実績については次のセクションで取り上げますが、現実の攻撃に耐えて生き残ったのは、そのうち一方だけです。
実際に脆弱なモデルはどれか
どのモデルファイルをコードとして扱うべきでしょうか。端的に言えば、名前から想像されるよりも多くのファイルであり、しかもそのほとんどは .pkl という名前ではありません。
| フォーマット | ロード時に実行されるか? | 備考 |
|---|---|---|
| .pkl .pickle .dill | はい | 最も典型的なケース |
| scikit-learn .joblib | はい | joblib は pickle をラップしている |
| PyTorch .pt .pth .bin | はい | ZIP でラップされた pickle。2.6 以降は weights_only=True(後述) |
| NumPy .npy .npz | allow_pickle=True の場合のみ | CVE-2019-6446 以降、デフォルトは False。オブジェクト配列では必要になるため、再び有効化されてしまう |
| Keras/TensorFlow .h5 .hdf5 | はい | Lambda レイヤーがあり、レガシーなパスでは safe_mode が無視される |
| Keras .keras (v3) | はい(バイパス経由) | CVE-2025-9906 を参照 |
| TensorFlow SavedModel | 実質的にはい | グラフ演算とカスタムレイヤー |
| safetensors | いいえ | 名前付きテンソルと JSON ヘッダーのみ。オペコードも呼び出し可能オブジェクトもない |
| GGUF | 既知の経路なし | 量子化推論用のテンソルとメタデータ |
| ONNX | 既知の経路なし | Protobuf の計算グラフ。事前定義された演算のみ |
最後の 2 行の表現に注目してください。「既知のコード実行経路なし」です。これらのフォーマットは pickle より新しく、攻撃される頻度も低いため、公開された CVE がないことは、そもそも呼び出しを表現できないフォーマットに比べればはるかに弱い根拠です。
戦略 1:ローダーを制限しても、バイパスされる
フォーマットは維持しつつ、安全であることがわかっている呼び出し可能オブジェクトのサブセットだけを許可する。これは標準ライブラリ自身の助言です。主要な 2 つのフレームワークはどちらもこの助言に従いましたが、それでもバイパスされました。
PyTorch は、バージョン 2.6 で torch.load の weights_only 引数のデフォルトを False から True に切り替えました。明確にセキュリティ上の理由からです。制限付きのアンピクラーは、テンソル、ストレージ、基本的なコレクションを許可し、それ以外はすべて拒否します。
ただし、2.5.1 以前では、weights_only=True はすでにバイパス可能でした。CVE-2025-32434 は、古い tar ベースのチェックポイントを扱うパスである _legacy_load が、処理するすべてのものに対して制限付きアンピクラーを実際には強制していなかったことを明らかにしました。フラグは設定されていたのに、実行されたコードはそれを尊重していなかったのです。
そして、同じことが再び起きました。2026 年 1 月に CVSS 8.8 で公開された CVE-2026-24747 は、細工したオペコードによって制限付きアンピクラーの検証を破り、メモリを破壊してコード実行に到達します。影響を受けるのは 2.10.0 より前のすべてのバージョンです。つまり、2025 年のバイパスに対する修正自体が、2.6 から 2.9 までの全範囲でエクスプロイト可能だったということです。2025 年初めに、セキュアなデフォルトだからと PyTorch 2.6 に固定していたなら、4 つのマイナーバージョンにわたってエクスポージャーが残っていたことになります。
Keras も同じ構図で、しかも反復がさらに多くなっています。Lambda レイヤーはマーシャルされた Python を保持し、ロード時にそれを実行します(CVE-2024-3660))。Keras は 2.13 から safe_mode=True をデフォルトにし、それらのデシリアライズを拒否するようにしました。
その後、CVE-2025-9905 により、レガシーな .h5 ファイルのロードでは safe_mode が無視されることが判明しました。警告もエラーもありません。攻撃者は、チェックポイントを古いフォーマットで作成するだけでよく、最新のライブラリでもそれをロードしてコードを実行してしまいます。
最後に CVE-2025-9906 です。細工した .keras アーカイブの config.json が keras.config.enable_unsafe_deserialization() を呼び出し、そのうえで Lambda レイヤーを仕込みます。ファイル自身が、自分を検査しているチェックを無効化するのです。
同じ 705,991 件の Hugging Face モデルの調査で、リサーチャーは 91 件の悪意あるモデルを発見し、そのうち 15 件は Keras の Lambda レイヤーを使っていました。
戦略 2:ロードする前にファイルをスキャンしても、悪意あるファイルを見逃す
成果物を保存状態で検査し、悪意がありそうなら拒否する。これは Hugging Face がアップロード時に実行しているものであり、ほとんどの継続的インテグレーション(CI)ゲートが使っているものでもあります。
Sonatype は 2025 年に picklescan の 4 件の脆弱性を開示しました。そのうち 3 件は、仕組みこそ違えど、同じ失敗を表しています。
- CVE-2025-1889:標準的な検知が、内容ではなくファイル拡張子に基づいていました。攻撃者がファイル名を変更すれば、そのファイルは一度もスキャンされませんでした。
- CVE-2025-1944:意図的に壊した ZIP により、
picklescanはBadZipFileでクラッシュします。より寛容な PyTorch の ZIP リーダーは、同じファイルを問題なくロードします。 - CVE-2025-1945:攻撃者が ZIP のフラグビットを書き換えると、
picklescanは検知に失敗しますが、PyTorch は変わらずロードします。
さらに、2025 年 2 月に ReversingLabs が Hugging Face 上で発見した nullifAI があります。これらのモデルは、PyTorch のデフォルトである ZIP ではなく、7z で圧縮されていました。Picklescan はそれらをパースしませんでした。
1 つのバグが、6 回繰り返された
| 脆弱性 | ギャップ |
|---|---|
| PyTorch CVE-2025-32434 | _legacy_load パスで weights_only が強制されない |
| Keras CVE-2025-9905 | レガシーな H5 パスで safe_mode が無視される |
| Keras CVE-2025-9906 | ファイル自身が、そのファイルを検査するチェックを無効化する |
| picklescan CVE-2025-1889 | スキャナーは拡張子を読み、ローダーは内容を読む |
| picklescan CVE-2025-1944 および 1945 | スキャナーの ZIP パーサーは厳格で、ローダーのパーサーは寛容 |
| nullifAI | スキャナーは ZIP を想定し、ローダーは 7z も受け入れる |
どのケースでも、チェックを行うものとロードを行うものが、ファイルが何であるかについて食い違っていました。攻撃者はチェックを打ち破ったのではなく、チェックが適用されないファイルの読み方を見つけたのです。
これは単なる不運の連続ではなく、構造的な問題です。チェックする側は、あらゆるローダーが、あらゆるバージョンの、あらゆるレガシーコードパスで、バイト列をどう解釈するかを予測しなければなりません。一方、ローダーはそれを 1 通りに解釈するだけでよく、それが悪意あるファイルの見逃しにつながります。
pickle は有効なものでなくても機能する
nullifAI のモデルは、意図的に壊されていました。
第 1 節で述べたとおり、pickle VM はオペコードに出会った順に実行します。検証のパスはありません。ペイロードはストリームの先頭に置かれていたため、デシリアライズが破損箇所に到達してエラーを投げる頃には、os.system はすでに呼び出されていました。ReversingLabs が述べたように、オペコードは「すべてのオペコードが実行されるか、壊れた命令に遭遇するまで」実行されます。
ファイル全体をパースしてパースエラーを報告するスキャナーは、何も有用なことを報告していません。被害者はすでに侵害されています。データはパースしてから使うので、壊れたファイルからは何も得られません。プログラムは障害が起きるまで実行され、障害より前のことはすべてすでに起きています。モデルファイルをデータとして扱うことは、単なるスタイル上の誤りではありません。
「実際に脆弱なモデルはどれか」のセクションの表をもう一度見てください。下の行のフォーマットが安全なのは、十分にパッチされているからではなく、safetensors のファイルには呼び出しを表現できるもの、つまりオペコードも、呼び出し可能オブジェクトも、再構築手順も存在しないからです。このセキュリティ特性は、そのフォーマットが「表現できないこと」の帰結であり、だからこそ信頼するのにバージョン番号を必要としません。
これが、フォーマット変換を勧める論拠のすべてです。しかし、変換が常に可能とは限らず、多くの本番システムが今日も pickle をロードしています。そこで次の問いは、それらが実行されたときに何が見えるのか、ということになります。
検知
悪意あるモデルを捉えられる場所は 2 つあります。ロードされる前と、実行されている最中です。両者は異なる方向で失敗し、その違いが重要です。
保存時のスキャン
スキャンは主要なコントロールです。低コストで、CI で実行でき、何かが実行される前に成果物をブロックでき、教科書どおりのペイロードに対しては機能します。os.system を呼び出す __reduce__ ガジェットは、まさに modelscan や picklescan が見つけるために作られたものです。
第 3 節に挙げた CVE が、それで安心できない理由です。そのリストにあるバイパスはいずれも、スキャナーが、自分が読んでいると信じていたファイルに対して正しく動作していたにもかかわらず、それを打ち破りました。拡張子のチェック、ZIP のパース、フラグビット、7z、そして意図的に壊されたストリームなどです。検知ロジック自体が壊されたものはなく、入力された時点でファイルの正体が変えられていたのです。
明白なケースを捉えるスキャナーは、明白なケースが捉えられたことを教えてくれるだけです。ファイルが安全だとは言えません。「安全」と言うには、あらゆるローダーが、あらゆるバージョンの、あらゆるレガシーパスで、そのバイト列をどう読むかを予測している必要があり、それは膨大な組み合わせを推論しなければならず、スキャンだけで済ませることを現実的でなくします。これが非対称性です。
ですから、本当の問いは、スキャンするかどうかではなく、スキャンがバイパスされたときに何が残るのか、ということです。
実行を監視する
ランタイム検知は、論理的な答えとして提案されるレイヤーなので、実際に計測してみましょう。
私たちは 5 つの敵対的なガジェットファミリーを構築しました。それぞれ __reduce__ が異なるポストエクスプロイトの動作を行う pickle で、これらを 2 つのエンジンに対して実行しました。デフォルトのルールセットで動作するオープンソースの Falco 0.44.1 と、Sysdig Secure です。
どちらの実行でも、最初にポジティブコントロール(陽性対照)を発火させました。5 つの結果はすべて、実行前に書面で予測しておきました。
| ガジェットファミリー | OSS Falco(デフォルトルールセット) | Sysdig Secure |
|---|---|---|
| 機密ファイルの読み取り(シェル経由) | FIRED · Read sensitive file untrusted | FIRED · 1.6 秒 |
| 機密ファイルの読み取り(直接、シェルなし) | FIRED · 同じルール | FIRED · 1.9 秒 |
| 機密ファイルの読み取り(プロセス内、プロセス生成なし) | FIRED · 同じルール | FIRED · 1.5 秒 |
| 複合(読み取り+外部への通信) | FIRED · 同じルールのみ | FIRED · + System procs network activity |
| .pth スタートアップフックによる永続化 | Modify Python Startup Hook File | FIRED · 1.5 秒 · Python .pth Persistence File Written by Non-Package-Manager |
5 つのガジェットファミリーすべてが Sysdig Secure のルールを発火させ、いずれも 2 秒以内でした。OSS Falco のデフォルトでは、5 つのうち 4 つが発火しました。Falco のオープンソースのデフォルトルールセットには 26 個のルールが含まれており、商用製品の 278 個と比べると少なくなっています。このなかには、このテストの後に作成された Falco ルール Modify Python Startup Hook File も含まれます。
ただし、この表からは、単純なスコアよりも重要な 3 つの発見があります。
第一に、プロセス生成の有無という軸は無関係です。シェルをフォークするガジェットと、Python プロセスの外に一切出ないガジェットとでは、見え方が違うだろうと予想していましたが、検知に違いはありませんでした。 シェルを生成するガジェットは 1.6 秒、直接実行するものは 1.9 秒、完全にプロセス内で完結するものは 1.5 秒で捉えられました。3 つとも同じルールが捉えました。ガジェットがフォークするかどうかは、そのシステムコールの表面に関する事実であって、可視かどうかに関する事実ではありません。
第二に、ランタイム検知それ自体は、チェッカーとローダーの食い違いという問題を解決しませんが、解決する必要もありません。ランタイムセンサーは、デシリアライズそのものを一切観測せず、その結果だけを観測します。この表の中で、pickle がロードされたことを検知したものはありませんでした。発火したのは、pickle の下流で発生したファイルの読み取りや外部への接続でした。
これは些末なことに聞こえますが、これを捉えるはずに見えるルールを読むと状況がわかります。Shell Spawned with Inline Python Command は、proc.pcmdline に -c が含まれ、かつソースコードの文字列そのもの、つまり import os と os.system が含まれていることをキーにしています。Base64-encoded Python Script Execution は、エンコードを 1 段階挟んだだけで同じことをします。どちらも、悪意ある Python がコマンドライン上で見えることを前提にしています。
そして第三に、pickle のロードは python3 load_pickle.py model.pkl です。ガジェットはファイルの中にあります。そのテキストは、どのエンコード層でも、コマンドライン上には一切現れません。
脆弱なモデルをどうしてもデプロイする場合のベストプラクティス
ここまで確認してきたとおり、単一のレイヤーだけで万全というものはありません。しかし、それは何もしなくてよいという主張ではありません。レイヤーを、その失敗の仕方によって並べるべきだという主張です。
以下のスタックは強度順に並べてあり、それぞれがより強固な防御アプローチの一部です。
1. フォーマットを変換して、問題そのものをなくす。
ほとんどのモデルは、名前付きの数値配列以外をシリアライズする必要がありません。あなたのモデルもそうであれば、呼び出しを表現できないコンテナに保存してください。重みには safetensors、量子化推論には GGUF、計算グラフが必要な場合は ONNX です。
この 3 つの違いは、思われている以上に重要です。Safetensors は構造的に安全です。テンソルと JSON ヘッダーで構成されており、フォーマットのなかに呼び出し可能オブジェクトを表現できるものがないからです。GGUF と ONNX は「既知の経路なし」ですが、これはフォーマットの表現力の限界というより、現時点のリサーチ状況についての主張にすぎません。特に ONNX は、完全な演算子グラフを持ち、パーサーの CVE の履歴もあります。新しいモデルをデプロイするときは、「表現できないこと」によって安全であるフォーマットを選んでください。
注意点:「既知の経路なし」は「安全であることが証明された」という意味ではなく、変換が常に可能とも限りません。pickle としてのみ配布されているモデルは、変換するために一度ロードする必要があります。それはビルドホストではなく、下記のステップ 5 のサンドボックスで行ってください。
2. ローダーをバイパスされたバージョンより先に固定し、実際に動作しているバージョンを確認する。
PyTorch の場合、最も安全なのはバージョン 2.10.0 以降です。weights_only=True のデフォルトは 2.6 で導入され、修正として広く報じられましたが、CVE-2026-24747 は制限付きアンピクラー自体を破り、2.10.0 より前のすべてのバージョンに影響します。セキュリティ上の助言に従って 2025 年初めに 2.6 に固定したチームは、その後の 4 つのマイナーバージョンにわたって、エクスポージャーが残ったままでした。
Keras の場合は、常に最新を使用し、そのパスでの safe_mode を信頼するのではなく、レガシーな .h5 の入力を拒否してください。CVE-2025-9905 は、警告なしに safe_mode が無視されるケースです。NumPy では allow_pickle=False を維持し、それを切り替えるコードは検出結果として扱ってください。
注意点:このレイヤーは、このリストの中でも、おそらく最も実績が悪いものです。上に挙げたエントリーはすべて、それ自体があとからバイパスされた修正です。固定はしてください。ただし、それで得られたように見える信頼を使い果たしてはいけません。
3. 保存時に、CI でゲートとしてスキャンする。
取り込み時に modelscan または picklescan を実行し、デプロイではなくビルドを失敗させてください。低コストで、ありふれたケースを捉えられます。実際に遭遇するもののほとんどは、そのようなケースです。
注意点:スキャナーはブロックリスト方式であり、評価した CVE はすべて、正しく動作していたスキャナーを打ち破りました。スキャン結果がクリーンであっても、それは証拠がないというだけのことです。それを、成果物を本番に昇格させるシグナルにしてはいけません。
4. 出所(プロベナンス)を確立する。
どのモデルがどこから来たのかを追跡してください。自分でビルドしたものには署名し、取り込むものは検証し、同じことをしている発行元を優先してください。
注意点:署名が証明するのは出所であって、意図ではありません。Hugging Face で見つかった悪意あるモデルは、アップロードしたアカウントによって、正当にアップロードされたものでした。プロベナンスは、誰を信頼しなければならないかを絞り込みますが、その信頼に値するかどうかまでは教えてくれません。
5. エグレス境界のあるサンドボックス内でロードする。
これはこのリストの中で最も地味なコントロールですが、最も確実に効果を発揮します。盗む価値のある認証情報がなく、永続化されるものへの書き込み権限がなく、明示的なエグレスの許可リストがあるプロセスで、モデルをロードしてください。
これは、攻撃を見抜くことに依存しない、ここで唯一のコントロールです。その必要がないからです。通信が悪意あるものかどうかを判断するのではなく、許可されているかどうかだけを判断します。
注意点:サンドボックスはブラストラディウス(影響範囲)を限定しますが、実行を防ぐわけではありません。コードは依然として実行されます。あなたは、そのコードが何に到達できるかを選んでいるのです。
6. 常に侵害を前提とし、ランタイム検知を最後の砦として使う。
ここまでのものはすべて、ファイルについての予測です。ランタイムは、実際に何が起きたかを観測する唯一のレイヤーです。ランタイムの可観測性を使って、コードが実際に何をしているのかを確認し、悪意ある活動を捉えてください。
注意点:この場合、無害に見える挙動に対しては沈黙し、ロードそのものを見ることはなく、その結果だけを見ます。
なぜその順序が重要なのか
最初の 4 つのコントロールをもう一度読み返すと、1 つの明確なパターンがあります。どれも、ファイルがどう解釈されるかを予測することで機能するということです。コンバーターはフォーマットを予測します。固定されたローダーは、どのコードパスが実行されるかを予測します。スキャナーは、ローダーがそのバイト列をどう扱うかを予測します。署名は、既知の発行元が、意図したとおりのものを作ったと予測します。
あらゆるバイパスは、攻撃者がそれらの予測と食い違うインタープリターを見つけたものです。そして、それが止まると期待する理由はありません。それを生み出す非対称性が決して解消しないからです。チェックする側は、あらゆるローダーを予測しなければなりません。ローダーはファイルを 1 通りに解釈するだけでよく、実際に実行されるのはそのローダーです。
サンドボックスとランタイムセンサーは、このリストの中で、予測をしない 2 つのコントロールです。サンドボックスは、ファイルが何であるかを気にしません。すでに実行されているコードが何に到達できるかを制約します。センサーも同様に気にしません。プロセスが何をしたかを報告します。
しかし、だからといって、それらが単独で十分になるわけではありません。ランタイムはデシリアライズを観測せず、悪意ある Python を捉えるはずに見えるルールは、悪意がコマンドライン上で見えることを前提にしており、洗練された層であるはずの相関レイヤーは、一度も発火しませんでした。
結局のところ、最も包括的なアプローチは「両方とも」という戦略です。スキャナーとローダーが食い違えば、バイパスが生まれます。スキャナーとセンサーが食い違えば、アラートが生まれます。
モデルファイルはプログラムです。データのために作られたパイプラインを通すべきではなく、モデルファイルをチェックするために使うものは、それをロードするものとは共有していない、そのバイト列の読み方を持っていると想定しなければなりません。
Sysdig TRT による最新の脅威リサーチをご覧ください
もっと読む